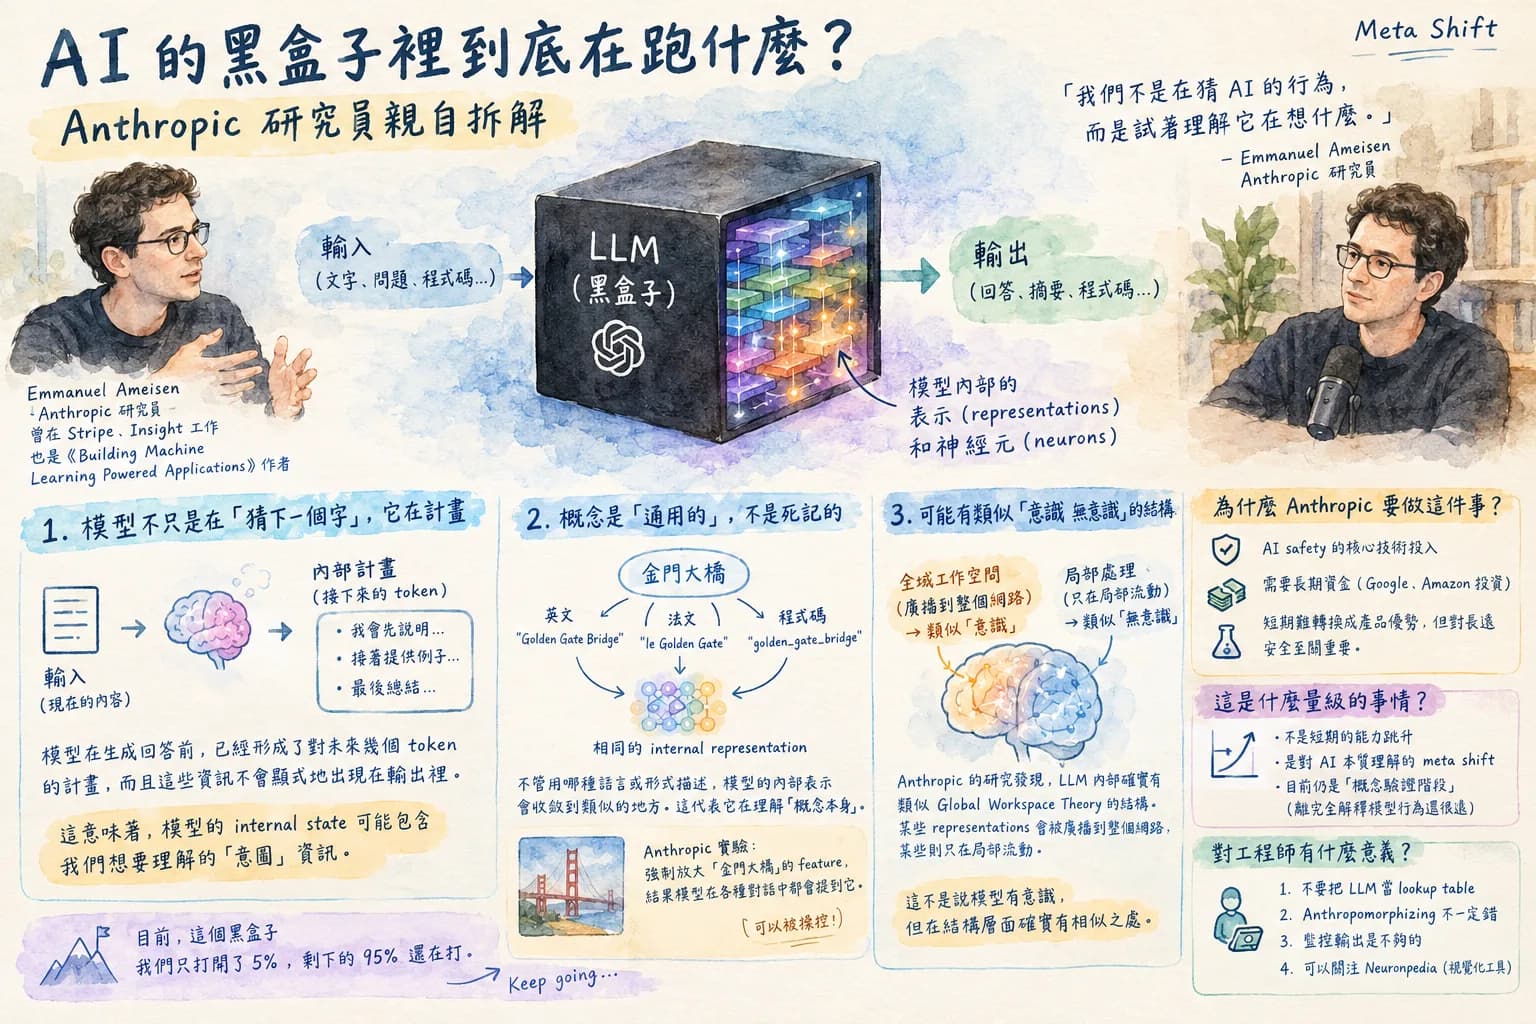
AI 黑盒子裡面在跑什麼 — Anthropic 研究員怎麼拆解模型思維
2026年10月20日 · Waiting7777 · 8 分鐘閱讀
AIAnthropicLLMinterpretabilityAI 的黑盒子裡面到底在跑什麼?Anthropic 研究員親自拆解
> Meta Shift
大部分人對 AI 的理解停在「它就是個 next-token predictor」——輸入文字,預測下一個字,重複。這個說法不是錯的,但解釋力也就到這裡而已。
Emmanuel Ameisen 是 Anthropic 的 interpretability 研究員,之前在 Stripe 和 Insight 做過多年 applied ML,也是《Building Machine Learning Powered Applications》的作者。他在 Lenny's Podcast 做了一集訪談,難得的是,這不是那種「AI 很厲害、未來很光明」的業配型訪談 — 他真的在解釋模型內部在跑什麼,以及我們目前到哪個理解程度。
我把整集拆解一遍,因為我覺得這是工程師視角最值得看的一種 AI 內容:不是教你怎麼 prompt、不是談商業模式,是直接問「這個東西到底怎麼運作」。
架構概覽:interpretability 研究在解決什麼問題
先講清楚 interpretability 這個領域在幹嘛。
你訓練一個 LLM,給它幾千億個參數,訓練完之後它能回答問題、寫程式、做摘要。但問題是 — 你不知道它為什麼能做到這些。你看不到它的「推理過程」,你只能看到輸入和輸出。這個中間的黑盒子,就是 interpretability 研究想打開的東西。
傳統的 ML interpretability 研究(比如 saliency maps、LIME、SHAP)是從外部去推測模型重視哪些 feature。但 Anthropic 做的 interpretability 不太一樣 — 他們試圖直接去讀模型的內部表示,理解模型在「想什麼」。
整個研究框架大概長這樣:
訓練好的模型
    ↓
找出 internal representations(模型在各層的 activation)
    ↓
分析這些 representations 對應到哪些概念
    ↓
追蹤概念之間的 circuit(哪些 neuron 在互相影響)
    ↓
還原模型的「推理路徑」
這個方向最早是 Chris Olah(現在也在 Anthropic)透過 Distill 推廣的,概念是「neuron 可能對應到人類可理解的概念」。但實際上比這個複雜很多,因為一個 neuron 可以同時編碼很多不同的概念(polysemanticity),不是一對一的乾淨關係。
核心機制深入
1. 模型不只是在「猜下一個字」,它在計畫
Ameisen 強調的一個重點是:next-token predictor 這個 framing 嚴重低估了模型實際在做的事。
根據 Anthropic 的研究(論文:Tracing the thoughts of a large language model),模型在生成回答之前,已經在內部形成了對「接下來幾個 token」的計畫 — 而且這個計畫不會顯式地出現在輸出裡。換句話說,模型的 internal state 包含了還沒說出口的資訊。
這跟「逐字猜測」的直覺完全不同。比較接近的類比是:一個人在說話之前,大腦已經想好了大概要說什麼,嘴巴只是在執行輸出。
這件事的 implication 很重要:如果模型真的在做前瞻性的計畫,那它的 internal representation 就可能包含我們想要理解的「意圖」資訊。這對 alignment 研究很關鍵 — 如果我們能讀出模型的計畫,我們就能在它做壞事之前抓到它。
Trade-off 是:這種 planning 是否可靠、是否一致,目前還不清楚。模型可能在某些任務上做很多前瞻計畫,在其他任務上完全沒有。
2. 概念是「通用的」,不是死記的
另一個有趣的發現是,模型形成的 representations 是 general 的,不是死記特定文字的 pattern matching。
Ameisen 提到,當你問模型關於某個概念的問題,不管你用英文、法文、還是程式碼來描述這個概念,模型的 internal representation 其實會收斂到類似的地方。這代表它確實在某種程度上理解「概念本身」,而不只是表面的文字形式。
Anthropic 有一個研究叫 Golden Gate Claude — 他們找到了模型裡面「金門大橋」這個概念對應的 feature,然後把那個 feature 強制放大,結果模型在各種對話裡都會不斷提到金門大橋(即使你完全沒問)。這個實驗證明了 feature 跟概念之間確實有對應關係,而且可以被操控。
這很嚇人,但也很有趣 — 代表 interpretability 研究不只是在「看」模型,還可以「寫入」模型。
3. 模型可能有結構上類似「意識 / 無意識」的區別
這是整個訪談最讓我印象深刻的部分。
Anthropic 有一篇研究叫「A global workspace in language models」,研究的是模型內部是否有類似 Global Workspace Theory 的結構。Global Workspace Theory 是認知科學裡的一個理論,大意是人類的意識是一個「廣播系統」 — 某些資訊被廣播到整個大腦的「全域工作空間」,這些被廣播的資訊就是你意識到的東西;沒被廣播的就是無意識處理。
研究發現,LLM 內部確實有類似的結構 — 某些 representations 會被廣播到整個網路的各個部分,某些則只在局部流動。這不是說模型有意識,但在結構層面上,有某種跟意識 / 無意識區別相似的東西在運作。
Ameisen 很謹慎地說,這個發現的意義是什麼,目前還不知道。但這件事本身就很值得思考。
商業背景:Anthropic 為什麼在做這件事
Anthropic 的核心定位是「AI safety 公司」,interpretability 研究是這個定位的核心技術投入之一。邏輯很直接:你要讓 AI 安全,你得先知道它在做什麼。
但這裡有個很現實的問題:interpretability 研究極其燒錢,而且短期內很難直接轉換成產品優勢。Google、OpenAI 在這塊的投入都遠不如 Anthropic,因為他們的商業壓力更直接。
Anthropic 的資金來源目前已知的有 Google 和 Amazon 的大額投資(據報導 Amazon 投入了 40 億美金),這給了他們相對充裕的空間做長期研究。但這不代表這條路是商業上最優的 — interpretability 的研究成果要轉換成用戶能感受到的產品價值,中間的路徑還很長。
訪談裡 Ameisen 提到一個有趣的說法:模型是「grown」(種出來的),不是「built」(蓋出來的)。意思是訓練過程不像工程 — 你不是設計每一個零件,你是設計訓練環境,然後讓模型自己長出能力。這個說法其實準確描述了為什麼 interpretability 這麼難:你沒有設計這個系統,你怎麼可能完全理解它?
Meta 判讀:這是什麼量級的事情
這不是 patch note,也不是短期的能力跳升。這是對 AI 這個東西本質理解的 meta shift。
長期以來 scaling 是主要的研究方向 — 更多資料、更多參數、更多算力,模型就更強。這個方向沒有錯,但它是個黑盒子加大版本的黑盒子。interpretability 走的是完全不同的路:先理解現有模型在做什麼,再想辦法控制它。
Ameisen 提到 scaling 的能力跳升(capability jumps)看起來是突然的,但其實背後有一條平滑的 scaling curve。模型一直在進步,只是到了某個臨界點之後,這些進步突然變得「可見」。這個觀察其實對投資人和產品決策者都很重要:不要只看「現在能做什麼」,要看曲線走向。
目前 interpretability 研究的成熟度,我的評估是:概念驗證階段。他們能找到一些有意義的 features 和 circuits,能做一些可重複的實驗,但距離「能完全解釋一個模型的行為」還差很遠。
實戰建議:這件事對工程師有什麼意義
老實說,如果你是做應用層的工程師,interpretability 研究現在對你的日常工作影響不大。這是研究層面的東西,工具還沒有成熟到可以直接用。
但有幾個點值得記住:
1. 不要把 LLM 當 lookup table。 它不是在查資料庫,它在做某種形式的推理。這代表你怎麼 prompt、你給什麼 context,會影響的不只是輸出,而是模型走的「推理路徑」。這解釋了為什麼同樣的問題換個說法,答案會差很多。
2. Anthropomorphizing 不一定錯。 Ameisen 說,把模型當人來想,有時候是比較準確的直覺。不是因為模型有感情,而是因為它的內部結構確實在某些地方跟人類認知有結構上的相似性。
3. 監控輸出是不夠的。 這是 alignment 研究給工程師的提醒 — 如果模型在內部已經形成了某個計畫,但計畫沒有出現在輸出裡,你光看輸出是抓不到的。未來如果這類 safety 工具成熟,interpretability 會是關鍵基礎。
Neuronpedia 是一個把 Anthropic 的 interpretability 研究成果視覺化的工具,如果你對這個主題有興趣,可以去玩一下。目前主要是研究用途,但值得追蹤。
這個黑盒子,打開的進度大概是 5%。剩下的 95%,還在打。
延伸閱讀
Waiting7777
WoW Arena 冠軍轉前端,用電競 meta 思維拆解技術趨勢。
相關文章
 AI商業模式+1
我開始寫判讀紀錄:三個有日期、會被打臉的預測
科技文章最便宜的寫法是「這件事很重要」。這裡改成押注:寫下日期、理由跟信心,時間到了回來對答案,錯了也不刪。
2026年10月20日 · Waiting7777 · 4 分鐘閱讀
繼續閱讀 → MetaMuse Spark+4
Meta Muse Wonder 評測:對 AI Agent 有用,但設計師可能不買單
從設計師和工程師的雙重視角評價 Muse Wonder — 到底誰受益、誰受害,Meta 的策略意圖在哪裡。
2026年10月18日 · Waiting7777 · 6 分鐘閱讀
繼續閱讀 → SalesforceAI+17
AI 會取代業務嗎?Sales in the Age of AI 的幾個觀察
從工程師賣產品的角度評論 AI 對 sales 的衝擊,哪些 outbound 動作真的可以自動化,哪些是 AI 做不好的,以及 sales 這個職位在 AI 時代的新定位。
2026年10月16日 · Waiting7777 · 7 分鐘閱讀
繼續閱讀 →這篇文章對你有幫助嗎?
每週一篇 — 技術趨勢背後的商業邏輯
AI 產業在變什麼、工程師該注意什麼——拆清楚寄到你的信箱。