GPT-6 Astra 怎麼運作的?Looped Transformer 和隱藏推理鏈拆解
2026年9月11日 · Waiting7777 · 8 分鐘閱讀
GPTAI技術分析Transformer 架構OpenAI 為什麼要把 GPT-6 Astra 做成「會迴圈的 Transformer」
> Meta Shift
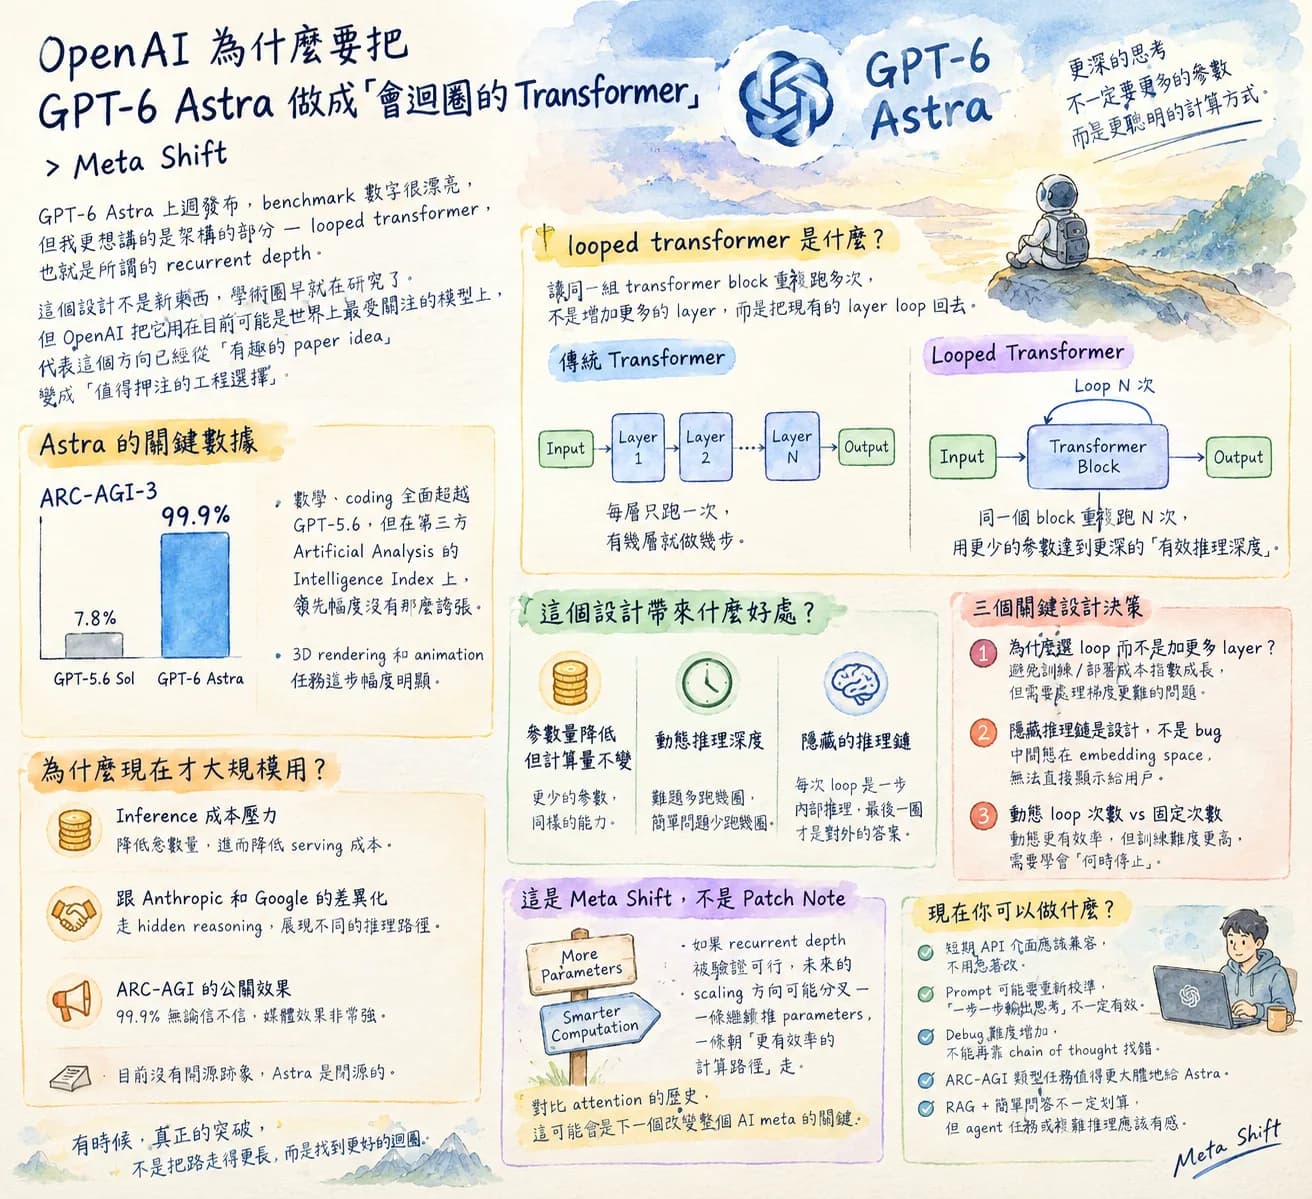
GPT-6 Astra 上週發布,benchmark 數字很漂亮,但我更想講的是架構的部分 — looped transformer,也就是所謂的 recurrent depth。
這個設計不是新東西,學術圈早就在研究了。但 OpenAI 把它用在目前可能是世界上最受關注的模型上,代表這個方向已經從「有趣的 paper idea」變成「值得押注的工程選擇」。所以我想拆解一下:這個設計到底在解決什麼問題、為什麼現在才大規模用、以及背後的工程取捨是什麼。
順帶一提,這篇主要是基於 Sebastian Raschka 的分析,加上我自己的判讀。Raschka 這篇文章在社群拿到 336 分,可見這個方向確實觸動了很多人的神經。
先說 Astra 的數字
不廢話,直接看幾個關鍵數據:
- ARC-AGI-3:Astra 拿到 99.9%,而前一代 GPT-5.6 Sol 只有 7.8%,這個跳躍幅度是誇張的(來源:OpenAI 官方部落格)
- 數學和 coding benchmark 全面超越 GPT-5.6,但在 Artificial Analysis Intelligence Index 上,領先幅度沒有像 ARC-AGI-3 那麼誇張
- 3D rendering 和 animation 任務上,Astra 的進步幅度明顯高於其他類別,Raschka 特別提到這點
ARC-AGI-3 這個數字我是看一眼就皺眉 — 因為從 7.8% 到 99.9% 這種跳法,通常有兩種可能:benchmark 本身被 overfit 了,或者模型的推理架構真的發生了質變。考慮到 looped transformer 的設計,我傾向相信後者有一定的貢獻,但也不排除前者的成分。
Artificial Analysis 的 Intelligence Index 是比較可信的第三方評估,因為他們用獨立的 harness(像是 Stirrup),不是讓 OpenAI 自己跑。在那個 index 上,Astra 確實領先,但沒有 OpenAI 自己的數字那麼戲劇性。這個差距本身就值得注意。
Looped Transformer 是什麼
傳統的 transformer 是一個 feedforward 的結構 — input 進去,經過 N 層 transformer block,output 出來。每一層只跑一次,沒有回頭。
Looped transformer(或叫 recurrent depth)的核心想法是:讓同一組 transformer block 重複跑多次。不是增加更多的 layer,而是把現有的 layer loop 回去。
# 概念示意(不是實際 code,只是幫助理解)

# 傳統 Transformer
x = input
for layer in layers:       # 每層只跑一次
    x = layer(x)
output = x

# Looped Transformer
x = input
shared_block = TransformerBlock()
for step in range(num_loops):   # 同一個 block 跑 N 次
    x = shared_block(x)
output = x
這個設計有幾個直接的影響:
參數量降低,但計算量不變。 你可以用更少的參數做到類似深度,因為同一組 weights 被反覆使用。對於部署成本和記憶體用量是好事,但 FLOPs 不會少。
模型可以「想多久就想多久」。 傳統 transformer 的推理深度是固定的,有幾層就做幾步。Looped transformer 可以動態調整 loop 的次數,難題就多跑幾圈,簡單問題少跑幾圈。這跟人類思考困難問題會花更多時間是類似的直覺。
跟 chain of thought 的關係。 這裡是比較有趣的地方 — hidden chain of thought 的傳言說 Astra 在輸出答案前有內部的推理步驟,但這些步驟不對外顯示。Looped transformer 天然地支持這種設計:每一次 loop 可以看作一步「內部推理」,最後一圈的 output 才是對外的答案。
三個關鍵設計決策
1. 為什麼選擇 loop 而不是直接加更多 layer?
這是最核心的問題。加 layer 是最直觀的做法,GPT-4 到 GPT-5 大概就是這條路。但這條路有明顯的天花板:
- 訓練成本指數增長。 Layer 數量增加,parameter count 增加,訓練成本也跟著炸。
- 部署成本。 更大的模型在 inference 時的記憶體佔用和延遲都更高。
- Scaling law 的邊際報酬遞減。 大家都觀察到,純粹靠增加參數量的效益在近幾年已經明顯放緩。
Looped transformer 的 trade-off 是:你用更少的新參數,換取更深的「有效推理深度」。代價是訓練難度 — 因為梯度要透過多次 loop 往回傳,vanishing/exploding gradient 的問題更難處理。這也是為什麼這個設計在學術圈討論很久,但工業界一直到現在才大規模採用的原因之一。
2. Hidden reasoning chain 是設計,不是 bug
傳言說 Astra 隱藏了它的推理過程。有人解讀成「OpenAI 故意不讓你看到思考過程」,當成一種商業策略(可能怕被競爭對手學走推理邏輯)。
但從架構角度看,這很可能是 looped transformer 的自然結果,而不是刻意的 feature。如果推理發生在 loop 的中間狀態(intermediate representations),那這些狀態本來就不是 token,你沒辦法直接把它顯示出來。這不像 o1/o3 那種「先輸出 thinking tokens 再輸出答案」的設計 — looped transformer 的中間推理是在 embedding space 裡進行的,對用戶完全不可見。
這個設計的優點是效率:不需要先生成一大串 thinking tokens 再生成答案,推理和計算是整合在一起的。缺點是可解釋性歸零,你完全不知道模型在每個 loop 裡做了什麼。
3. 動態 loop 次數 vs. 固定 loop 次數
這是目前研究上還在討論的問題。固定次數的 loop 比較好訓練,但浪費計算資源(簡單問題也要跑 N 圈)。動態次數(讓模型自己決定要 loop 幾次)更有效率,但訓練難度大幅增加,因為你要同時學「什麼時候停下來」。
根據最近的 paper(Raschka 在文章中有引用,但具體 paper 名稱在摘錄中沒有完整列出),有研究在探索讓模型學習 early exit — 當信心程度夠高就停止 loop。這跟 mixture of experts 裡的 routing 概念有點像,都是讓模型學習「這個問題需要多少計算資源」。
商業背景:OpenAI 為什麼現在才用這個設計
Looped transformer 的研究至少可以追溯到幾年前,但 OpenAI 選擇在 GPT-6 這一代才大規模押注,背後有幾個商業邏輯:
Inference 成本壓力。 隨著 API 用量暴增,inference 成本是 OpenAI 最大的運營支出之一。如果 looped transformer 能在同等能力下降低參數量(進而降低 serving 成本),這個動機就很強。目前沒有公開數字,但這個方向的省錢潛力是真實的。
跟 Anthropic 和 Google 的差異化。 Claude 和 Gemini 在透明 chain of thought 上走得很深。OpenAI 如果選擇 hidden reasoning,某種程度上也是在說「我們的推理路徑跟你們不一樣」,即使最終效果類似。
ARC-AGI 的公關效果。 99.9% 這個數字不管你信不信,在媒體層面的效果是非常強的。Looped transformer 讓模型有更長的「有效思考時間」,在 ARC-AGI 這類需要多步推理的 benchmark 上確實有結構性優勢。
開源策略目前沒有跡象,Astra 顯然是閉源的。
Meta 判讀:這是 Meta Shift
我把 looped transformer 判定為 Meta Shift,不是 Patch Note。
原因是:這個架構改變了「更好的模型 = 更多 layer + 更多參數」這個假設。如果 recurrent depth 的路徑被驗證可行,未來的 scaling 方向可能會分叉 — 一條繼續堆 parameters,一條朝「更有效率的計算路徑」走。
對比一下歷史:attention mechanism 剛出來的時候,也有人說「這只是一種 trick」,但它最後改變了整個 NLP 的 meta。Looped transformer 有沒有這個量級,現在還太早說,但 ARC-AGI-3 的跳躍讓我覺得值得認真對待。
跟 o1/o3 的 explicit chain of thought 比較:那個設計的問題是 token 生成成本隨推理深度線性增長,而且 thinking tokens 對用戶來說是噪音。Looped transformer 的 hidden reasoning 沒有這個問題 — 推理成本是計算成本,不是 token 成本。這是一個工程上更乾淨的設計。
實戰層面:現在你需要做什麼
如果你是在用 API 的工程師,短期內不用改什麼 — Astra 的 API interface 應該跟前代兼容,hidden reasoning 對你來說是透明的。
但有幾件事值得注意:
Prompt engineering 的邏輯可能要重新校準。 如果 Astra 的推理是在 loop 裡進行的,那「逼它一步一步輸出思考過程」的 prompt 策略(像是「let's think step by step」)可能效果不如以前,因為推理已經在 hidden 的地方發生了。
Debug 難度增加。 當模型給你一個錯誤答案,你以前還可以看 chain of thought 去找哪一步推錯了。Hidden reasoning 讓這條路不通,你只能靠測試案例堆砌來找問題。
ARC-AGI 類型的任務可以更大膽地給 Astra。 需要多步邏輯推理、空間推理、或複雜條件判斷的任務,現在值得重新試試看,因為 looped transformer 在這類任務上的結構優勢是真實的。
至於要不要升級到 Astra,看你的任務類型 — 如果你的 use case 主要是 RAG + 簡單問答,現有模型可能夠用了,成本換效益不一定划算。但如果是 agent 任務或複雜推理,這次升級應該是有感的。
延伸閱讀
Waiting7777
WoW Arena 冠軍轉前端,用電競 meta 思維拆解技術趨勢。
相關文章
 GPTAI+2
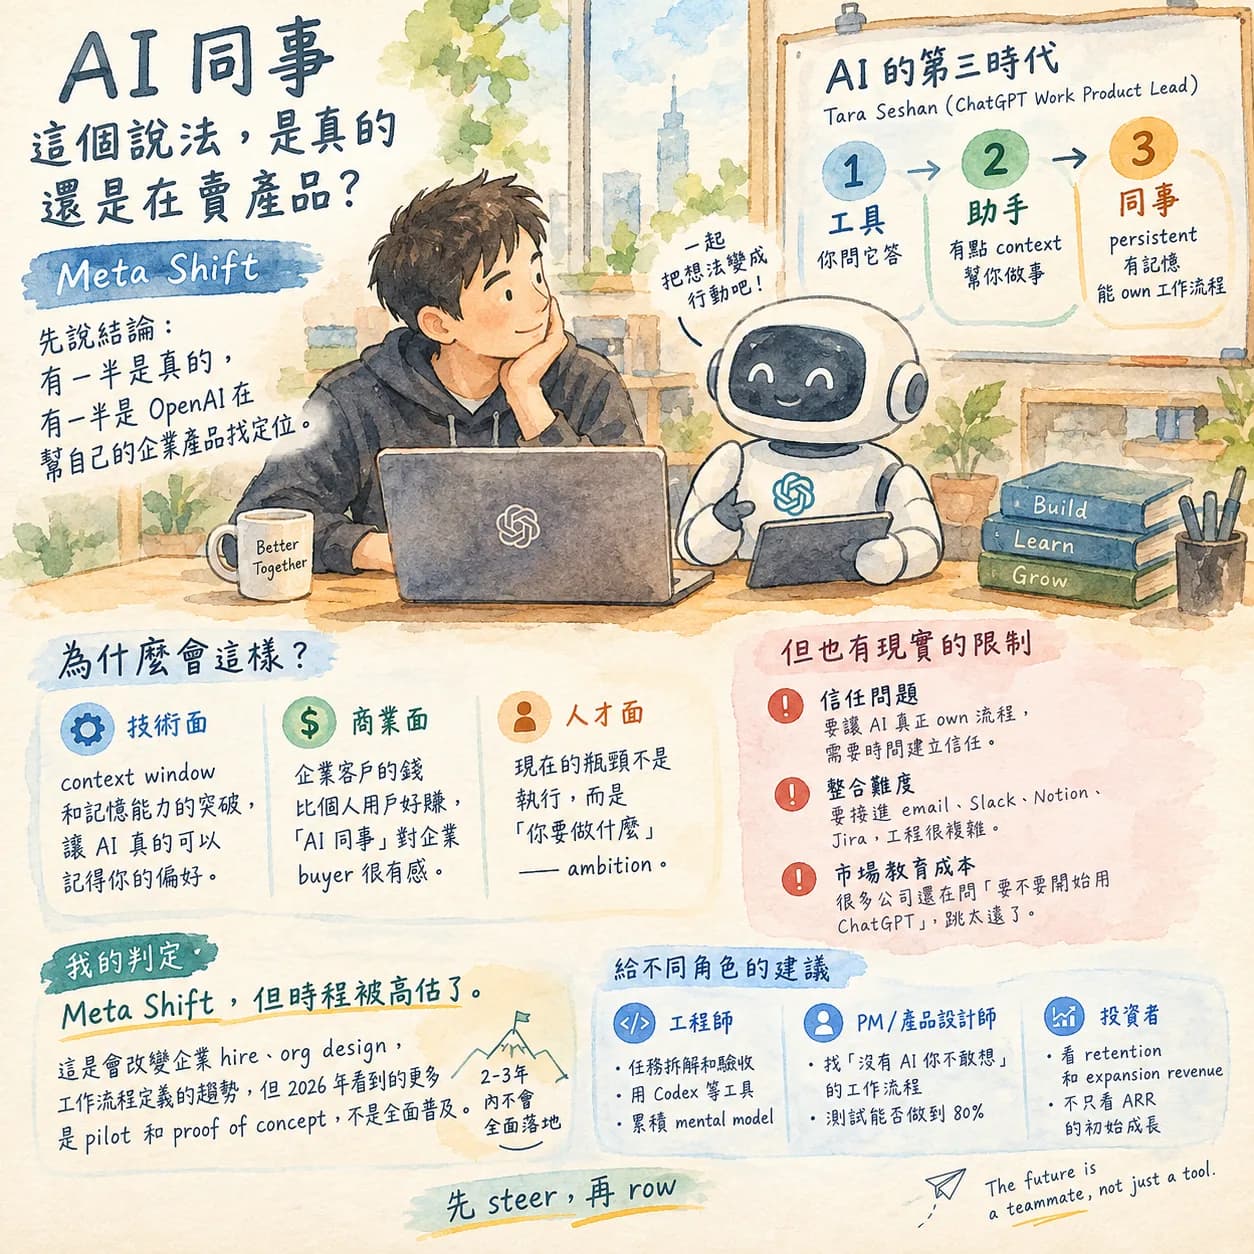
AI 第三時代:「永遠在線的 AI 同事」這個概念是真的嗎?
從「AI 同事」這個框架切入,評估這個概念是真實趨勢還是產品行銷話術 — 什麼樣的工作場景真的需要 persistent AI,什麼場景還是用工具就夠了。
2026年9月20日 · Waiting7777 · 7 分鐘閱讀
繼續閱讀 → AI監管+3
AI 大老們喊了幾年「管管我們吧」,然後呢?一份帶點諷刺的時間軸
從「說一套做一套」的角度切入:AI 高管喊監管不是新鮮事,但每次都有具體的時機背景。整理這條時間軸背後的商業動機 — 喊監管,往往是為了鞏固自己的護城河。
2026年9月18日 · HW SHU · 5 分鐘閱讀
繼續閱讀 →SnapAI Agents+13Snap 又在推 AR 眼鏡 AI 功能了 — 這次有機會嗎?
從「Snap 為什麼還在賭 AR 硬體」的角度切,分析 Specs + AI 這個策略對 Snap 的商業意義,以及在 Apple Vision Pro 和 Meta Ray-Ban 夾擊下,這條路還走不走得通。
2026年9月18日 · HW SHU · 6 分鐘閱讀
繼續閱讀 →這篇文章對你有幫助嗎?
每週一篇 — 技術趨勢背後的商業邏輯
AI 產業在變什麼、工程師該注意什麼——拆清楚寄到你的信箱。