AI 改完說 done,畫面真的沒壞嗎?用自架視覺回歸測試驗證 AI coding
AI 改完說 done,畫面真的沒壞嗎?用自架視覺回歸測試驗證 AI coding
現在叫 AI 改 code 已經是日常,改一個 component、調一段樣式、順手重構一下,它跑完 lint、跑完 unit test,回你一句「已完成,測試全部通過」,但 unit test 只驗證邏輯,不會告訴你這次改動有沒有讓另一個頁面的按鈕跑版,或是共用的 card component 改了 padding 之後,五個用到它的頁面一起歪掉,而接下來要接手的是一個有多年 legacy 的 Next.js 專案,要一邊改一邊不能壞,公司裡的 AI 又比較弱,code 和截圖也不能送到外部 SaaS,那麼要怎麼讓大家放心讓 AI 動手呢?
我的答案是每個 MR 都自動拍一次「改之前」跟「改之後」,逐像素比對,有差異就把差在哪裡直接貼到 MR 上,讓人看圖判斷,這樣 AI 改了什麼、改壞了什麼,不用相信它的自我回報,看截圖就知道。
整套東西的說明文件和完整程式碼放在這裡:自架視覺回歸測試 Kit,下面講它怎麼運作,以及實際搬到另一個專案時踩到的坑。
為什麼是視覺測試
AI 寫的 test 有個老問題,它很會寫「能通過的 test」,happy path 一定有測,但畫面長什麼樣子幾乎沒有人在測,而前端的回歸 bug 大部分剛好就是長相的問題,CSS 改一行影響的範圍很難從 diff 看出來,review 的人也不可能每個 MR 都把所有頁面點一遍。
視覺回歸測試把這件事變成機器的工作,它不需要知道 AI 改了什麼,也不需要理解程式碼,只要比較兩張截圖,所以不管是人寫的還是 AI 寫的,驗證方式都一樣。
怎麼比
基準不存檔,每次都用 git merge-base 找出這個分支從 main 分出來的那個 commit,用 git worktree 取出來現場 build、現場拍,再拍目前的程式碼,兩邊在同一個容器裡比,所以報告上的差異就剛好等於「這個 MR 改了什麼」,不會混進別人後來合進 main 的東西,也沒有「接受 baseline」這種要人維護的動作。
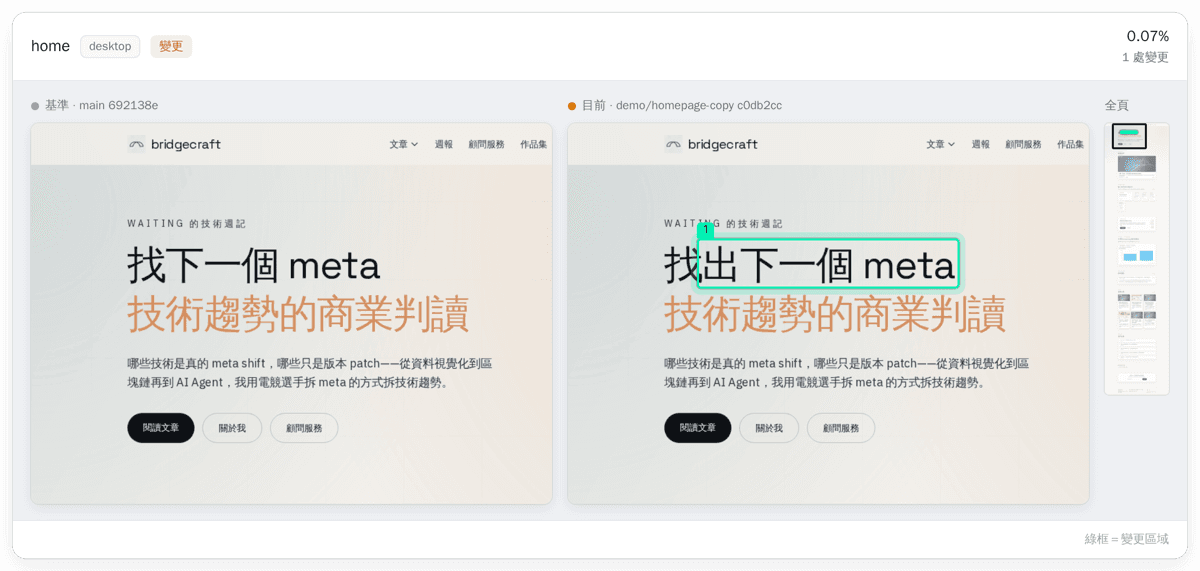
比對用 pixelmatch,差異像素會分群成一塊一塊的區域,MR 留言裡每個有變化的頁面都有一張卡片,左邊改之前、右邊改之後,變更的地方用綠框標出來,我拿自己的部落格試,只把首頁標題「找下一個 meta」改成「找出下一個 meta」,差異只有 0.07%,綠框剛好框在那一行字上,其他四頁判定沒變化,這種程度的改動靠肉眼看 diff 很容易漏掉。
截圖要先穩定
視覺測試最常見的死法是誤報,同一頁拍兩次就不一樣,報告每次都一堆差異,大家很快就學會無視它,所以大部分的力氣其實花在讓截圖可重現:
- 用
page.clock固定時間,前端打的 API 用page.route回傳固定資料 - GA、客服 widget 這些第三方直接擋掉
- 等字型、等圖片,關掉動畫和游標
- 每張圖連拍,連續兩張完全一樣才存檔,拍 5 次都不一樣就讓測試失敗,不存一張會造成假差異的圖
最後一條很重要,寧可讓測試明確失敗,也不要產生一個大家看了會不相信的報告。
搬到第二個專案才知道的事
這套一開始是在一個小 demo 專案裡做的,跑得很順,但要帶進公司之前,總得先在一個真的網站上試過,所以拿自己的部落格當白老鼠,結果一搬就踩了四個坑,每一個都是 demo 專案太簡單所以沒遇到的:
- build 的時候文章頁要用 service role key 讀按讚數,CI 上沒有這把 key 就 build 失敗,後來給一個假 key,讀取失敗時程式本來就當成 0,基準和目前版本兩邊都是 0,比對反而是穩定的,真的密鑰完全不用交給 CI
- 每個頁面都會 POST 一次來訪人數,如果沒有 mock 掉,每次跑 CI 都在灌正式資料庫的數字
- 手機版的長頁面,中段的 lazy load 圖片永遠不會載入,測試一路等到 timeout,因為原本的做法是捲到底再捲回來,中間那段根本沒進到畫面裡
- 部落格列表在 CI 上一直判定不穩定,原因是 next/image 縮圖失敗之後,元件會換上一張新的
<img>,而那張圖是在「等圖片載完」之後才出現的,後來改成連拍不一樣時重新等一輪,並且把最後兩張不一樣的截圖存下來跟著 CI artifact 上傳,下次再遇到直接看圖就好,不用像這次只能從 log 猜
第 4 個坑剛好說明了連拍檢查的價值,如果沒有它,那張還沒換好圖的截圖就會被存下來,然後每個 MR 的報告上都會出現一個莫名其妙的差異。
讓比較弱的 AI 也接得起來
公司裡的 AI 跑在不能連外網的 VM 裡,能力也比較弱,同樣的需求叫它從頭寫,大概寫不出來,所以 kit 的設計是「它不用寫,只要接」,說明文件最前面直接寫給 AI 看的指示,程式碼要原封不動複製,不要重寫、不要換套件,比對報告頁已經做好了不要自己做,然後把要依專案修改的地方整理成八個步驟,每一步都附範例,包括列出頁面、mock 會寫入資料的 API、用 data-testid 遮掉一直在動的 component。
最後一步是驗收,什麼都不改跑一次,結果必須全部無變化,再故意改一個 component 的樣式跑一次,應該只有用到它的頁面出現差異,而且綠框框在那個 component 上,兩項都對了才接 CI,這樣連「AI 有沒有把驗證工具接對」這件事,也是用同一套方法驗證的。
結論
AI coding 的瓶頸早就不是寫得夠不夠快,而是寫完之後誰來確認它是對的,邏輯可以靠 test,但畫面這一塊長期沒有人顧,視覺回歸測試剛好補上這個缺口,而且它不在乎 code 是誰寫的,只看結果,所以特別適合拿來驗證 AI 的改動,在不能用 SaaS 的環境裡,只要顧好截圖可重現跟兩邊在同一個環境拍這兩件事,自己刻一套其實不難,與其要求 AI 每次都保證沒改壞,不如給它一個改壞了一定會被看見的環境吧。
Waiting7777
WoW Arena 冠軍轉前端,用電競 meta 思維拆解技術趨勢。
相關文章
 LLMAI+2
2026 LLM 發展到底發生了什麼?年中整理加我的評分
借 Simon 的整理當骨架,加入自己的觀點:哪些進展是真的有感、哪些是被過度炒作的?給工程師一個有觀點的 2026 LLM 年中總結。
2026年10月1日 · Waiting7777 · 7 分鐘閱讀
繼續閱讀 →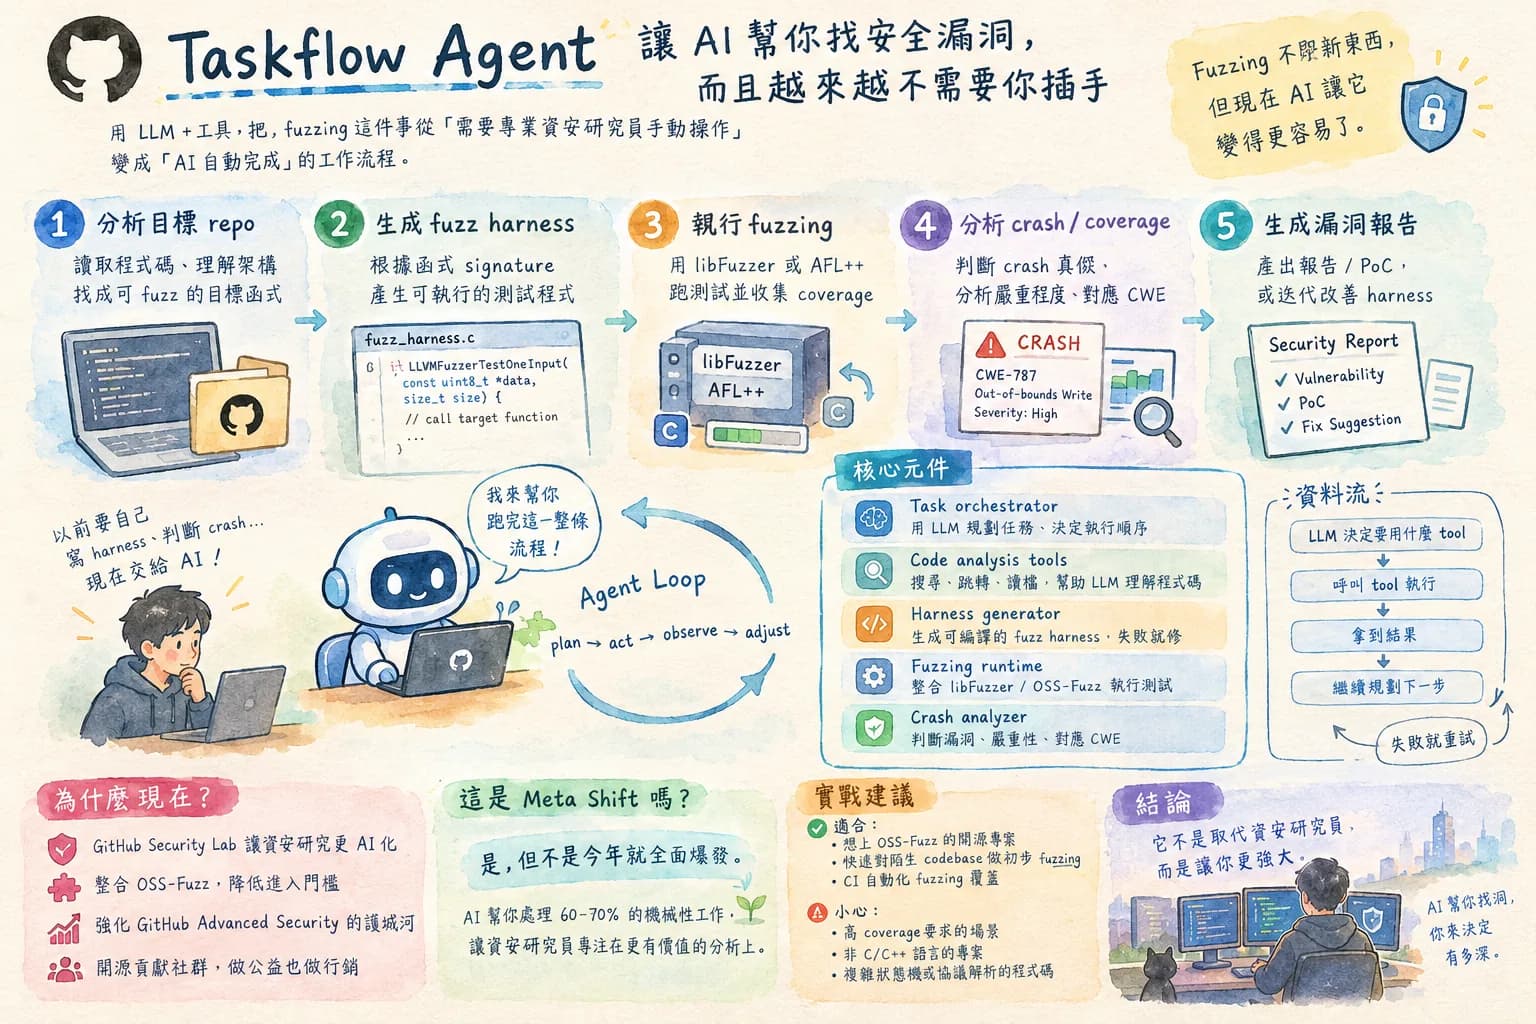 GitHub CopilotAI Agents+5
GitHub 用 AI 自動跑 fuzzing — 資安測試要被取代了嗎?
AI 做 fuzzing 這件事的意義不只是「測試更快」,而是把過去需要資安專家才能做的事民主化了。拆解 Taskflow Agent 的工作流程,評估它實際上能取代多少人工、局限在哪。
2026年9月25日 · Waiting7777 · 7 分鐘閱讀
繼續閱讀 →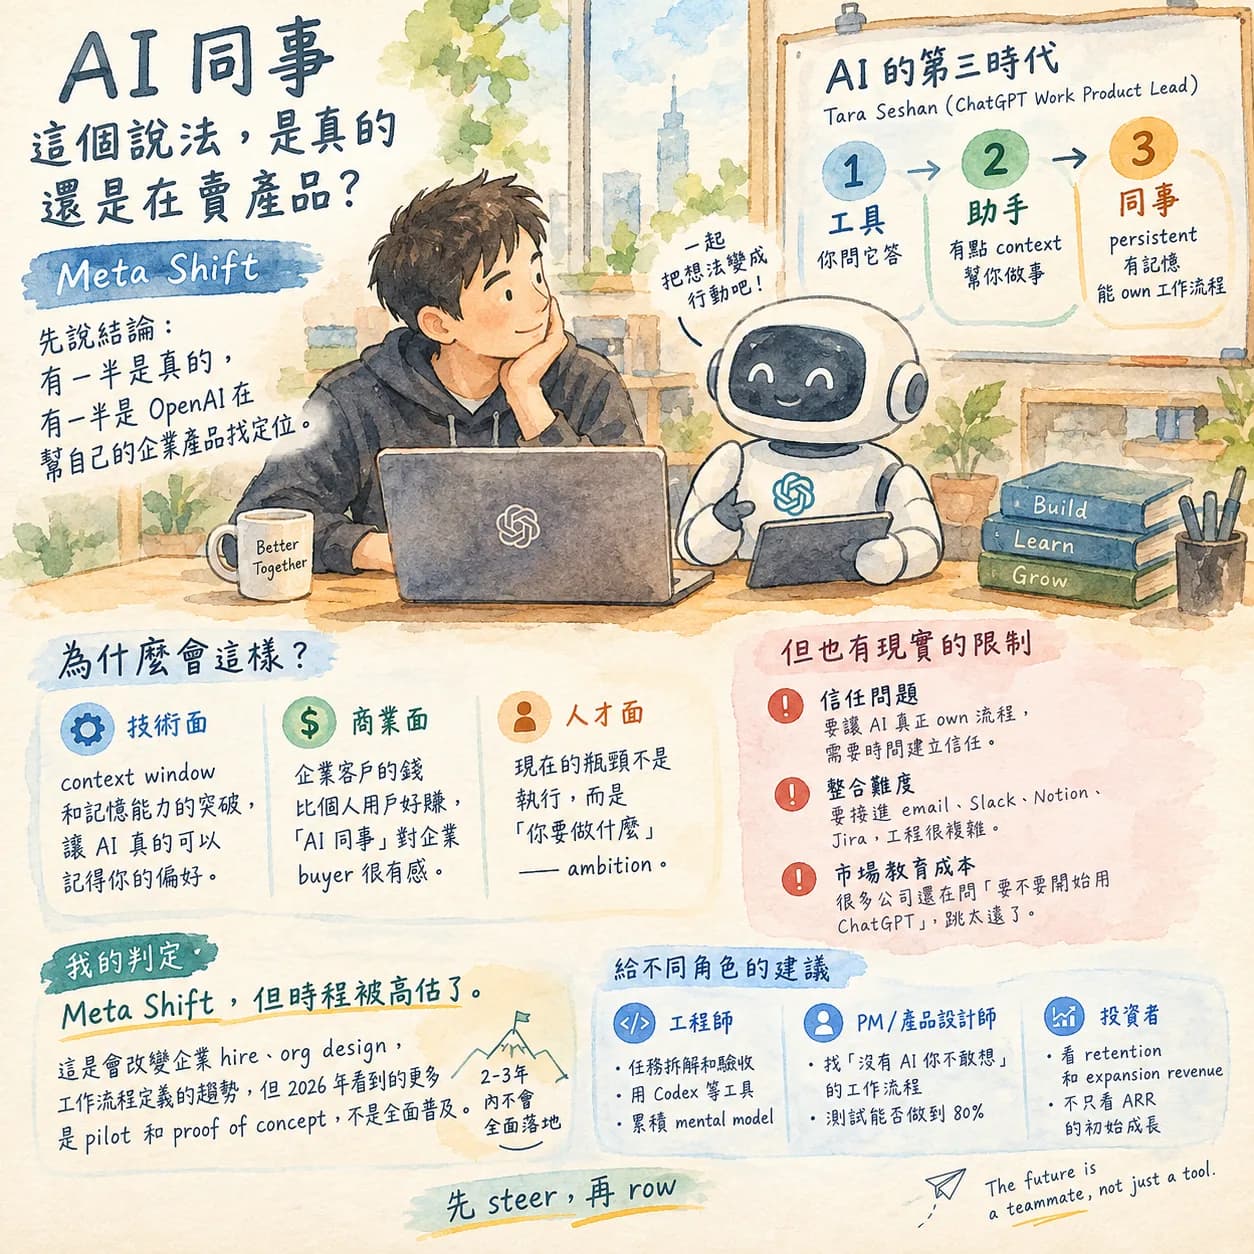 GPTAI+2
AI 第三時代:「永遠在線的 AI 同事」這個概念是真的嗎?
從「AI 同事」這個框架切入,評估這個概念是真實趨勢還是產品行銷話術 — 什麼樣的工作場景真的需要 persistent AI,什麼場景還是用工具就夠了。
2026年9月20日 · Waiting7777 · 7 分鐘閱讀
繼續閱讀 →這篇文章對你有幫助嗎?
每週一篇 — 技術趨勢背後的商業邏輯
AI 產業在變什麼、工程師該注意什麼——拆清楚寄到你的信箱。